Cihon et al. (2025 공개본) · 영향과 감독으로 읽는 자율성
SoLaR 2024 워크숍 논문의 2025 arXiv v1; 코드 검사 기반 평가 틀과 적용 사례
1. 논문 소개
Cihon과 동료들은 에이전트를 실제로 실행하지 않고, 에이전트를 조정하는 코드의 특징을 검사해 자율성을 평가하는 방법을 제안한다. 수업에서 읽는 판본은 SoLaR 2024 워크숍 논문의 2025년 2월 arXiv v1이다. 이 방법은 자율성을 영향과 감독으로 나누어, 시스템이 무엇을 할 수 있는지와 사람이 어떻게 관여하는지를 확인한다.[1]
연구진은 이 평가 틀을 AutoGen 프레임워크와 그 응용에 적용했다. 응용 열 개를 연구자 세 명이 평가하고, 합의한 결과를 제시한다. 전체 평가 범주에서 평가자 간 일치도인 Fleiss’ κ는 0.64로 보고된다. 이 수치는 평가자들의 판단이 얼마나 일치했는지를 나타낸다. 실제 운영 중의 안전이나 사용자의 신뢰를 측정한 값과는 구분해야 한다.[1]
2. 논문의 주요 내용과 이론
영향은 시스템이 할 수 있는 행동과 시스템이 접근하는 환경을 함께 보고 평가한다. 행동은 대화만 하는 상태, 미리 정한 도구를 쓰는 상태, 코드를 실행해 폭넓게 행동하는 상태로 나눈다. 환경은 접근을 제한한 상태, 보호된 실행 환경, 제약이 적은 접근으로 나눈다. 같은 행동 기능이라도 어디에 접근하느냐에 따라 결과가 미치는 범위가 달라질 수 있다.[1]
감독은 에이전트의 작업 흐름, 사람의 개입, 관찰 가능성으로 평가한다. 작업 흐름은 정해진 흐름, 유한한 유연성을 가진 흐름, 끝이 정해지지 않은 상호작용으로 나눈다. 사람의 개입은 매번 사람에게 입력을 받는 설정, 종료 조건에서 입력을 받는 설정, 입력을 받지 않는 설정으로 나눈다. 하위 에이전트의 행동이 복잡하면, 상위 단계에서 사람에게 묻는 설정만 보고 전체 감독 수준을 판단하기 어렵다.[1]
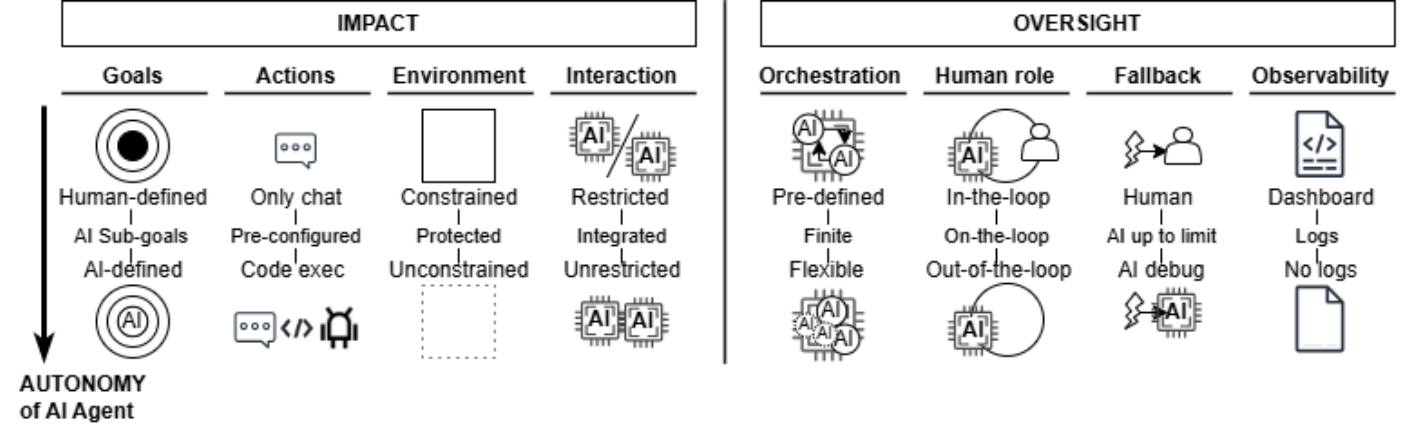
Cihon et al. · 그림 1: 영향과 감독으로 보는 자율성
영향 측면은 에이전트가 어떤 목표와 행동으로 어느 환경을 바꿀 수 있는지 다룬다. 감독 측면은 실행을 조율하는 방식, 사람의 역할, 실패했을 때의 대응, 관찰 가능성을 다룬다. 이 도식은 저자들이 코드 검사에 쓰는 분류 틀이다. 실제 운영에서의 안전성과 성능은 별도 평가로 확인한다.
원문 Figure 1 · PDF 1쪽. CC BY 4.0. 원문 그림을 그대로 발췌. 이용 조건
원문 그림 영역 발췌 · 한국어 해설은 수업에서 작성.
관찰 가능성은 사용자가 볼 수 있는 설명과 화면이 있는지, 로그가 있는지, 기록이 전혀 없는지에 따라 달라진다. 연구자들은 개발자에게 유용한 로그와 사용자가 의미 있게 이해할 수 있는 정보를 일관되게 구분하기 어려웠다고 보고한다. 행동 범주도 응용 개발자가 추가한 도구에 따라 평가가 복잡해졌다. 속성마다 평가자 간 일치 정도에도 차이가 있다.[1]
코드 검사는 에이전트를 실행하는 비용과 위험을 줄이고, 많은 시스템을 비교할 수 있게 한다. 그러나 실제 사용 환경에서 나타나는 예상 밖의 행동, 사용자에 대한 반응, 외부 의존과 자원 사용의 일부를 놓칠 수 있다. 논문의 표 1은 이런 장점과 한계를 나란히 정리한다. 저자들은 코드에서 확인한 가능한 행동 범위와 실제 행동을 함께 조사해 서로 보완해야 한다고 제안한다.[1]
3. AI 에이전트 시대의 시사점
위임 범위를 정할 때는 행동, 접근 환경, 작업 종료 조건, 승인 시점, 볼 수 있는 기록을 각각 적는다. 회사의 정책과 실제 시스템 설정이 같은 범위를 정하고 있는지도 확인한다. 이 다섯 항목을 운영 원칙에 넣자는 것은 논문을 바탕으로 한 수업의 제안이다.
사람이 시스템을 감독할 수 있는지는 필요한 정보, 내용 이해, 판단할 시간, 중단 권한까지 포함해 따로 확인해야 한다. 코드를 평가한 뒤에도 실제 과업에서 오류, 사람의 개입, 복구 과정을 관찰해야 한다. 운영 원칙에는 이런 후속 확인을 언제 어떤 조건으로 할지 적는다.